 Soba
Modellvergleich · Oktober 2026
Acht KI-Modelle, 200 Essensfotos: 53 bis 73 % der Kohlenhydrat-Schätzungen innerhalb von 10 g
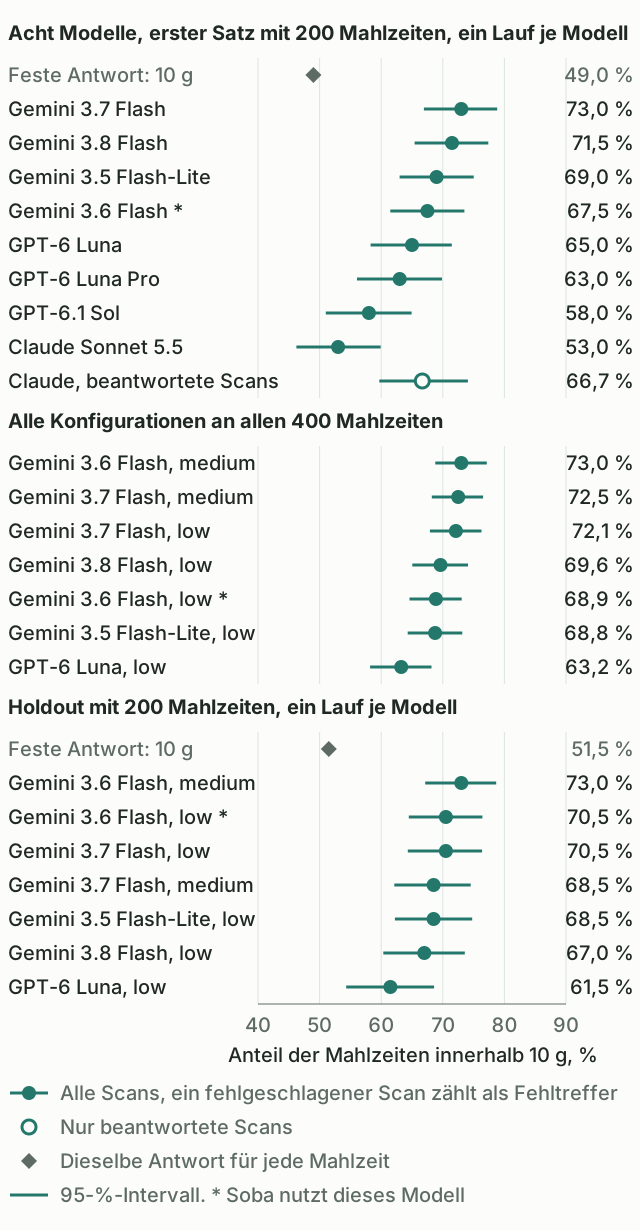
Vier Gemini-Flash-Modelle erreichten 67,5 bis 73,0 %, drei OpenAI-Modelle 58,0 bis 65,0 %. Claude Sonnet 5.5 erreichte 53,0 %, wenn 41 fehlgeschlagene Scans als Fehltreffer zählen, und 66,7 % bei den beantworteten Scans. Die Intervalle der vier Gemini-Modelle überlappen sich, deshalb benennt dieser Test kein einzelnes bestes Modell.
73,0 %höchster Wert der vier Gemini-Flash-Modelle, die 67,5 bis 73,0 % erreichten
65,0 %höchster Wert der drei OpenAI-Modelle, die 58,0 bis 65,0 % erreichten
53,0 %Claude Sonnet 5.5 über OpenRouter und Azure, bei beantworteten Scans 66,7 %
Wo jedes Modell gelandet ist
Alle acht Modelle bekamen dieselben 200 Fotos mit demselben Prompt, je ein Lauf. Ein fehlgeschlagener Scan zählt beim Anteil innerhalb von 10 g als Fehltreffer. Die anderen Fehlerspalten nutzen nur beantwortete Scans.
Tabelle 1. Acht Modelle am ersten Satz mit 200 Mahlzeiten
| Modell | Innerhalb 10 g, 95-%-Intervall | Mittlerer absoluter Fehler, g | Verzerrung, g | Fehler über 30 g | Fehlgeschlagene Scans | Kosten pro Scan, $ | Median-Zeit, s |
|---|---|---|---|---|---|---|---|
| Gemini 3.7 Flash | 73,0 % 66,9 bis 78,8 | 9,5 | −1,0 | 5,5 % | 0 | 0,0036 | 3,7 |
| Gemini 3.8 Flash | 71,5 % 65,4 bis 77,4 | 9,9 | −0,8 | 7,0 % | 0 | 0,0030 | 4,8 |
| Gemini 3.5 Flash-Lite | 69,0 % 63,0 bis 75,0 | 10,2 | +0,4 | 6,0 % | 0 | 0,0017 | 2,1 |
| Gemini 3.6 Flash * | 67,5 % 61,5 bis 73,5 | 10,1 | −1,4 | 5,5 % | 0 | 0,0028 | 3,3 |
| GPT-6 Luna | 65,0 % 58,3 bis 71,5 | 10,7 | +1,2 | 8,0 % | 0 | 0,0003 | 6,9 |
| GPT-6 Luna Pro | 63,0 % 56,1 bis 69,9 | 11,1 | +1,9 | 8,0 % | 0 | 0,0010 | 11,7 |
| GPT-6.1 Sol | 58,0 % 51,0 bis 64,9 | 14,9 | +10,1 | 11,5 % | 0 | 0,0071 | 13,1 |
| Claude Sonnet 5.5 | 53,0 % 46,2 bis 59,9 | 10,9 | +1,1 | 6,3 % | 41 | 0,0145 | 6,0 |
| Claude Sonnet 5.5, nur beantwortete Scans | 66,7 % 59,7 bis 74,1 | 10,9 | +1,1 | 6,3 % | 0 | 0,0138 | 5,2 |
* Soba nutzt dieses Modell mit Reasoning low. Der Stern markiert es in jeder Tabelle. Die zweite Zeile eines Anteils ist sein 95-%-Intervall. Fehler über 30 g sind ein Anteil an den beantworteten Scans.
- Die Skala beginnt bei etwa 50 %. Eine feste Antwort von 10 g für jede Mahlzeit käme auf 49,0 %, weil 49,0 % dieser Mahlzeiten höchstens 20 g Kohlenhydrate enthalten.
- GPT-6.1 Sol überschätzt am stärksten, im Schnitt um 10,1 g. Die anderen sieben Modelle bleiben innerhalb von 2 g um null.
- GPT-6 Luna kostet am wenigsten, 0,0003 $ pro Scan. Claude Sonnet 5.5 kostet am meisten, 0,0145 $.
- Gemini 3.5 Flash-Lite ist am schnellsten, im Median 2,1 s. GPT-6.1 Sol ist am langsamsten, mit 13,1 s.
Was wir gemessen haben
Ein Scan schickt ein Foto an ein Modell und fragt, was auf dem Teller liegt. Das Modell antwortet mit verwertbaren Kohlenhydraten und Ballaststoffen für jedes Lebensmittel. Wir addieren beides, weil die Datensätze Gesamtkohlenhydrate enthalten. Dann vergleichen wir die Summe mit dem Referenzwert der Mahlzeit.
Das Hauptmaß ist der Anteil der Mahlzeiten mit einer Abweichung von höchstens 10 g. Die Grenze von 10 g ist unsere Wahl, und mit der Datendatei kannst du jede andere Grenze prüfen.
- Mittlerer absoluter Fehler: die durchschnittliche Größe des Fehlers in Gramm.
- Verzerrung: der durchschnittliche Fehler mit Vorzeichen. Ein Minus bedeutet, dass das Modell zu niedrig schätzt.
- Fehler über 30 g: grobe Fehltreffer, als Anteil an den beantworteten Scans.
- Fehlgeschlagener Scan: ein Scan ohne gültige Antwort nach einem erneuten Versuch. Er zählt beim Anteil innerhalb von 10 g als Fehltreffer und hat in den anderen Spalten keinen Fehler.
- Kosten pro Scan: der von OpenRouter berechnete Betrag für den Lauf, erneute Versuche eingeschlossen.
- Median-Zeit: der ganze Scan, erneute Versuche eingeschlossen.
Daten
Zwei öffentliche Forschungsdatensätze liefern die Fotos und die Referenzwerte. Jeder Satz mit 200 Mahlzeiten enthält 100 Mahlzeiten aus jedem Datensatz.
Nutrition5k: gewogene Teller
Die Teller von Nutrition5k stammen aus Kantinen von Google. Jede Zutat wurde gewogen, und eine fest montierte Kamera fotografierte jeden Teller senkrecht von oben. Das sind die sichersten Referenzwerte in diesem Test. Die Lizenz ist CC BY 4.0.
SNAPMe: Fotos von zu Hause mit Ernährungsprotokoll
SNAPMe stammt vom US-Landwirtschaftsministerium und der UC Davis. 95 Personen in den USA fotografierten ihre Mahlzeiten vor dem Essen und führten ein Ernährungsprotokoll in ASA24, einem Werkzeug zur Erfassung der Ernährung. Der Referenzwert ist die Summe der Protokollzeilen, die zu einem Foto gehören. Deshalb enthält er die Fehler des Protokolls. Die Lizenz ist CC BY-SA 4.0.
Der Herausgeber nennt Benchmarks zur Nährwertschätzung als vorgesehene Nutzung und bittet darum, mit diesem kleinen Datensatz keine Modelle zu trainieren. Dieser Test trainiert nichts. Diese Seite und die Datendateien enthalten keine SNAPMe-Fotos.
Wie das Skript die Mahlzeiten ausgewählt hat
Ein Skript mit festem Zufallswert nahm je Datensatz 25 Mahlzeiten aus jedem Viertel des Kohlenhydratbereichs. Es begann mit 505 Tellern aus dem offiziellen Testsplit von Nutrition5k und 1.457 SNAPMe-Fotos, die vor einer Mahlzeit entstanden sind. Es nahm höchstens 2 Fotos pro SNAPMe-Person. Teller aus einem Zehn-Minuten-Fenster sehen sich oft ähnlich. Deshalb nahm das Skript für den ersten Satz 1 Teller pro Fenster und für den Holdout bis zu 3.
Den Holdout wählte das Skript auf dieselbe Weise. Er hat kein Foto, keine Mahlzeit und kein Zehn-Minuten-Fenster mit dem ersten Satz gemeinsam, SNAPMe-Personen können aber in beiden vorkommen. Der Median des Referenzwerts liegt im ersten Satz bei 20,3 g und im Holdout bei 19,1 g.
Methode und Prompt-Protokoll
Jeder Scan schickte am 7. Oktober 2026 ein Foto und denselben Prompt über OpenRouter. Kein Scan hatte einen Texthinweis, Tiefendaten oder eine spätere Korrektur. Wir haben jedes Foto auf 1.024 Pixel an der längsten Seite verkleinert, JPEG-Qualität 70. Der Testcode stellte die Antwortsprache auf Russisch.
- Anbieter: OpenRouter wählte Google AI Studio für Gemini, OpenAI für die OpenAI-Modelle und Azure für Claude. Die Anfrage erlaubte keinen Wechsel zu einem anderen Modell und setzte
data_collectionaufdeny. - Antwortformat: ein striktes JSON-Schema. Eine Prüfung lehnt einen leeren Lebensmittelnamen und ein Gewicht außerhalb von 0 bis 5.000 g ab und schickt dann einen erneuten Versuch mit dem Grund.
- Reasoning: low für alle acht Modelle. Low bedeutet je nach Anbieter etwas anderes. Im Mittel sind es pro erstem Versuch 0 bis 39 Reasoning-Token bei Gemini und Claude und 68 bis 590 bei OpenAI.
- Temperatur: 0,2, außer bei OpenAI-Modellen, die diese Einstellung nicht akzeptieren.
- Antwortlimit: 8.192 Token im ersten Satz, 4.096 im Holdout und 16.384 mit Reasoning medium. Normale Antworten bleiben unter 3.000 Token.
Der Prompt in Worten
Der Prompt ist der, den Soba im Oktober 2026 nutzte. Seinen Wortlaut halten wir geheim und beschreiben ihn hier. Er verlangt vom Modell Folgendes:
- Jedes essbare Lebensmittel benennen und ein zusammengesetztes Gericht in seine Teile zerlegen.
- Das Gewicht zuerst aus dem Maßstab schätzen: Gegenstände bekannter Größe, Fläche mal Schichthöhe mal Dichte oder Anzahl mal Stückgewicht.
- Für jedes Gewicht die Grundlage nennen und ein Minimum und ein Maximum angeben.
- Nährwerte pro 100 g im gezeigten Zustand angeben, verwertbare Kohlenhydrate und Ballaststoffe getrennt.
- Die Werte von einem sichtbaren Etikett übernehmen.
Wir haben diesen Prompt an Gemini entwickelt und abgestimmt, deshalb kann er Gemini begünstigen.
Intervalle
Die 95-%-Intervalle stammen aus einem Cluster-Bootstrap mit 10.000 Wiederholungen und dem Startwert 20261007. Ein Cluster ist eine SNAPMe-Person oder ein Zehn-Minuten-Fenster von Nutrition5k. Das Skript zieht die Cluster innerhalb jedes Datensatzes neu, und beide Datensätze zählen gleich viel. Differenzen zwischen Modellen nutzen dieselben Wiederholungen an denselben Mahlzeiten.
Für Mehrfachvergleiche haben wir nicht korrigiert. Acht Modelle ergeben 28 Paare, also können ein oder zwei Paare zufällig null ausschließen.
Ergebnisse an 200 Mahlzeiten: welche Abstände halten
Tabelle 2 vergleicht die Modelle Mahlzeit für Mahlzeit. Fett markiert eine Differenz, deren 95-%-Intervall null ausschließt. Ein Minus bedeutet, dass das Modell in der Zeile niedriger liegt als das Modell in der Spalte.
Tabelle 2. Differenzen im ersten Satz, in Punkten
| Modell | Differenz zu Gemini 3.7 Flash, Punkte | Differenz zu Gemini 3.8 Flash, Punkte | Differenz zu Gemini 3.5 Flash-Lite, Punkte | Differenz zu Gemini 3.6 Flash, Punkte |
|---|---|---|---|---|
| Gemini 3.7 Flash | Basis | +1,5 −2,5 bis +5,5 | +4,0 −1,4 bis +9,4 | +5,5 +0,9 bis +10,3 |
| Gemini 3.8 Flash | −1,5 −5,5 bis +2,5 | Basis | +2,5 −2,5 bis +7,7 | +4,0 −0,5 bis +8,6 |
| Gemini 3.5 Flash-Lite | −4,0 −9,4 bis +1,4 | −2,5 −7,7 bis +2,5 | Basis | +1,5 −3,0 bis +6,0 |
| Gemini 3.6 Flash * | −5,5 −10,3 bis −0,9 | −4,0 −8,6 bis +0,5 | −1,5 −6,0 bis +3,0 | Basis |
| GPT-6 Luna | −8,0 −14,5 bis −1,5 | −6,5 −13,2 bis +0,4 | −4,0 −10,5 bis +2,7 | −2,5 −9,5 bis +4,7 |
| GPT-6 Luna Pro | −10,0 −17,1 bis −3,0 | −8,5 −15,5 bis −1,5 | −6,0 −13,0 bis +1,0 | −4,5 −12,0 bis +2,9 |
| GPT-6.1 Sol | −15,0 −22,1 bis −7,7 | −13,5 −20,7 bis −6,0 | −11,0 −17,5 bis −4,6 | −9,5 −16,1 bis −2,7 |
| Claude Sonnet 5.5 | −20,0 −26,6 bis −13,1 | −18,5 −25,0 bis −11,8 | −16,0 −22,4 bis −9,5 | −14,5 −20,9 bis −8,0 |
- Die vier Gemini-Flash-Modelle liegen nah beieinander. Eines ihrer sechs Paare schließt null aus: Gemini 3.7 Flash gegen Gemini 3.6 Flash, +5,5 Punkte. Der Holdout hat das nicht wiederholt.
- GPT-6.1 Sol und Claude Sonnet 5.5, mit fehlgeschlagenen Scans als Fehltreffern, liegen unter allen vier Gemini-Flash-Modellen.
- GPT-6 Luna liegt nur unter Gemini 3.7 Flash. GPT-6 Luna Pro liegt unter Gemini 3.7 und 3.8 Flash. Ihre anderen Differenzen schließen null ein.
Wiederholte Läufe zeigen das Rauschen. Gemini 3.6, 3.7 und 3.8 Flash liefen zweimal auf diesen Fotos. Ihre Anteile änderten sich von 67,5 auf 67,0 %, von 73,0 auf 74,5 % und von 71,5 auf 73,0 %. Das Ergebnis blieb bei 94,5 bis 95,5 % der Mahlzeiten gleich. Der mittlere Abstand zwischen zwei Antworten auf ein Foto lag im Median bei etwa 1 g, der größte bei 59,5 g.
Tabelle 3. Derselbe Lauf nach Datensatz
| Modell | Nutrition5k, gewogen: innerhalb 10 g | Nutrition5k: mittlerer absoluter Fehler, g | SNAPMe, Protokoll: innerhalb 10 g | SNAPMe: mittlerer absoluter Fehler, g |
|---|---|---|---|---|
| Gemini 3.7 Flash | 82,0 % 74,0 bis 89,0 | 5,4 | 64,0 % 54,5 bis 73,2 | 13,6 |
| Gemini 3.8 Flash | 80,0 % 72,0 bis 87,0 | 5,9 | 63,0 % 53,5 bis 72,1 | 13,9 |
| Gemini 3.5 Flash-Lite | 81,0 % 73,0 bis 88,0 | 5,7 | 57,0 % 47,1 bis 66,7 | 14,7 |
| Gemini 3.6 Flash * | 80,0 % 72,0 bis 87,0 | 6,4 | 55,0 % 45,5 bis 64,4 | 13,7 |
| GPT-6 Luna | 71,0 % 62,0 bis 80,0 | 8,6 | 59,0 % 49,0 bis 68,6 | 12,7 |
| GPT-6 Luna Pro | 66,0 % 57,0 bis 75,0 | 9,3 | 60,0 % 49,5 bis 69,6 | 12,9 |
| GPT-6.1 Sol | 60,0 % 50,0 bis 70,0 | 11,1 | 56,0 % 46,0 bis 66,0 | 18,6 |
| Claude Sonnet 5.5 | 57,0 % 47,0 bis 67,0 | 6,8 | 49,0 % 39,4 bis 58,6 | 14,7 |
Der Abstand zwischen Gemini und OpenAI liegt bei den gewogenen Tellern. Dort erreichen die vier Gemini-Flash-Modelle 80 bis 82 % und die OpenAI-Modelle 60 bis 71 %. GPT-6 Luna Pro und GPT-6.1 Sol liegen 14 und 20 Punkte unter Gemini 3.6 Flash, mit Intervallen, die null ausschließen.
Bei den Fotos von zu Hause erreichen die OpenAI-Modelle 56 bis 60 %, also innerhalb der Gemini-Spanne von 55 bis 64 %. Dort unterscheiden sich nur Gemini 3.7 und 3.8 Flash von Gemini 3.6 Flash mit Intervallen, die null ausschließen, um +9 und +8 Punkte. Fotos von zu Hause sind für jedes Modell schwieriger, und die Protokolle bringen eigene Fehler mit.
Andere Läufe
Andere Läufe auf diesen Fotos änderten das Protokoll, deshalb stehen sie nicht in den Tabellen. Sie nutzten andere Prompt-Versionen, Temperatur aus, Reasoning high, Texthinweise und Tiefendaten. Die Genauigkeitsseite berichtet über Hinweise, Tiefendaten und Sobas späteren Code, der an 400 Mahlzeiten 68,5 % erreichte, wo Tabelle 5 den Wert 68,9 % zeigt. Ein neuntes Modell, Gemini 3.1 Pro Preview, lief mit späterem Code ohne Temperatur und erreichte 66,0 % (59,3 bis 72,5). Unsere Notizen nennen auch ein Qwen-Modell, das wir nach einem kurzen Versuch aussortiert haben. Davon haben wir keine Rohdaten behalten, deshalb steht es hier ohne Zahlen.
Claude Sonnet 5.5 über OpenRouter und Azure
Claude Sonnet 5.5 ist das einzige Modell mit fehlgeschlagenen Scans, deshalb gibt es zwei Sichten. Mit fehlgeschlagenen Scans als Fehltreffern erreicht es 53,0 %. Bei den 159 Scans mit Antwort erreicht es 66,7 %. Die erste Sicht zeigt, was man über diesen Weg bekommt. Die zweite zeigt das Modell, wenn es antwortet.
OpenRouter schickte alle 286 Anfragen an Azure, und jede lieferte HTTP 200 mit normalem Abschluss. Bei 86 von 200 ersten Versuchen enthielt die Antwort ein Lebensmittel mit leerem Namen und 0 g, während der Name des Gerichts ausgefüllt war. Unsere Prüfung lehnte diese Antworten ab und schickte einen erneuten Versuch.
- 41 erneute Versuche kamen wieder leer zurück. Das sind die 41 fehlgeschlagenen Scans: 24 bei Nutrition5k und 17 bei SNAPMe.
- 40 erneute Versuche lieferten eine echte Antwort.
- 5 erneute Versuche lieferten einen Platzhalter: ein Lebensmittel namens „x“ mit 1 g und ohne Nährwerte. Unsere Prüfung akzeptierte sie, also zählen sie als Schätzungen von 0 g, und 2 davon landen innerhalb von 10 g.
Tabelle 4. Alle Modelle an den Mahlzeiten, die Claude beantwortet hat
| Modell | 159 Mahlzeiten: innerhalb 10 g | 159 Mahlzeiten: mittlerer absoluter Fehler, g | Differenz zu Claude, Punkte | 154 Mahlzeiten: innerhalb 10 g | 154 Mahlzeiten: mittlerer absoluter Fehler, g |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | 73,0 % 66,7 bis 79,9 | 10,1 | +6,3 0,0 bis +12,8 | 72,1 % | 10,3 |
| Gemini 3.8 Flash | 73,0 % 66,7 bis 79,6 | 10,3 | +6,3 0,0 bis +12,8 | 72,1 % | 10,5 |
| Gemini 3.5 Flash-Lite | 71,7 % 65,4 bis 78,7 | 10,2 | +5,0 −1,0 bis +11,7 | 70,8 % | 10,5 |
| Gemini 3.6 Flash * | 69,2 % 62,9 bis 76,4 | 10,1 | +2,5 −3,6 bis +9,1 | 68,2 % | 10,4 |
| GPT-6 Luna | 67,3 % 60,4 bis 74,8 | 10,0 | +0,6 −6,9 bis +8,2 | 68,2 % | 9,7 |
| GPT-6 Luna Pro | 64,8 % 57,3 bis 72,2 | 10,5 | −1,9 −10,0 bis +5,9 | 66,2 % | 10,2 |
| GPT-6.1 Sol | 62,9 % 55,1 bis 70,8 | 14,5 | −3,8 −11,7 bis +3,7 | 64,3 % | 14,3 |
| Claude Sonnet 5.5 | 66,7 % 59,7 bis 74,1 | 10,9 | Basis | 67,5 % | 10,6 |
An den 159 Mahlzeiten erreichen Gemini 3.7 und 3.8 Flash 73,0 %. Das sind 6,3 Punkte über Claude, mit einem Intervall von 0,0 bis +12,8, und jede andere Differenz schließt null ein. Ohne die 5 Platzhalter, an 154 Mahlzeiten, erreicht Claude 67,5 %, und jede Differenz schließt null ein. An den Mahlzeiten, die es beantwortet hat, liegt Claude also im Rahmen der Intervalle gleichauf mit den anderen Modellen.
Beide Sichten haben Grenzen. Die 53,0 % können den Weg beschreiben und wenig über das Modell sagen. Wir haben keinen anderen Weg getestet und wissen nicht, warum die leeren Lebensmittel auftraten. Die 66,7 % lassen 41 Mahlzeiten aus, und die übrigen 159 sind etwas leichter. Die anderen sieben Modelle gewinnen dort 0,0 bis 4,9 Punkte. Erneute Versuche kosten auch mehr: 0,0113 $ pro Scan mit einer Anfrage und 0,0189 $ mit zwei.
In einem anderen Preprint lieferte Claude Sonnet 4.6 über die Batch-API von Anthropic bei allen Anfragen auswertbare Lebensmittel (Street, Tabelle 9). Dieser Test nutzte eine andere Modellversion und einen anderen Weg, deshalb erklärt er dieses Ergebnis nicht.
Sieben Konfigurationen an allen 400 Mahlzeiten
Tabelle 5 fasst den ersten Satz und den Holdout zusammen. Sie nennt jede Konfiguration, die an allen 400 Mahlzeiten lief: fünf Einstellungen von Gemini Flash, Gemini 3.5 Flash-Lite und GPT-6 Luna. Gemini 3.6, 3.7 und 3.8 Flash mit Reasoning low liefen im ersten Satz zweimal, deshalb mitteln wir die zwei Läufe pro Mahlzeit. Kosten und Zeit umfassen alle Scans einer Konfiguration.
Tabelle 5. Jede Konfiguration an allen 400 Mahlzeiten
| Modell | Innerhalb 10 g, 95-%-Intervall | Mittlerer absoluter Fehler, g | Verzerrung, g | Fehler über 30 g | Fehlgeschlagene Scans | Kosten pro Scan, $ | Median-Zeit, s | Differenz zu Gemini 3.6 Flash, low, Punkte |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.6 Flash, medium | 73,0 % 68,8 bis 77,1 | 9,4 | −2,7 | 5,5 % | 0 | 0,0059 | 6,6 | +4,1 +1,6 bis +6,7 |
| Gemini 3.7 Flash, medium | 72,5 % 68,2 bis 76,5 | 9,3 | −3,0 | 6,8 % | 0 | 0,0060 | 5,8 | +3,6 +0,2 bis +7,1 |
| Gemini 3.7 Flash, low | 72,1 % 67,9 bis 76,3 | 9,3 | −2,3 | 6,0 % | 0 | 0,0034 | 3,7 | +3,2 +0,3 bis +6,4 |
| Gemini 3.8 Flash, low | 69,6 % 65,1 bis 74,1 | 9,8 | −2,2 | 7,2 % | 0 | 0,0030 | 5,0 | +0,8 −2,3 bis +3,9 |
| Gemini 3.6 Flash, low * | 68,9 % 64,6 bis 73,1 | 9,5 | −2,0 | 5,8 % | 0 | 0,0031 | 3,4 | Basis |
| Gemini 3.5 Flash-Lite, low | 68,8 % 64,3 bis 73,2 | 10,0 | −0,9 | 7,8 % | 0 | 0,0017 | 2,2 | −0,1 −3,5 bis +3,4 |
| GPT-6 Luna, low | 63,2 % 58,2 bis 68,2 | 11,4 | +0,5 | 10,2 % | 0 | 0,0003 | 7,6 | −5,6 −10,3 bis −1,0 |
Drei Konfigurationen liegen über Sobas Einstellung, Gemini 3.6 Flash mit Reasoning low, mit Intervallen, die null ausschließen: +4,1, +3,6 und +3,2 Punkte. GPT-6 Luna liegt 5,6 Punkte darunter, mit einem Intervall von −10,3 bis −1,0.
Zwei Prüfungen schwächen diese Gewinne ab. Gemini 3.7 Flash lag im ersten Satz unter acht Modellen vorn, deshalb überschätzt der erste Satz es. Allein im Holdout beträgt sein Vorsprung vor Gemini 3.6 Flash 0,0 Punkte.
Reasoning medium bei Gemini 3.6 Flash gewinnt vor allem an der Grenze von 10 g. Innerhalb von 5 g erreicht es 49,0 % gegen 50,2 %, und seine Fehler über 30 g bleiben bei 22 gegen 23. Es verdoppelt auch die Kosten, 0,0059 $ gegen 0,0031 $, und die Zeit, 6,6 s gegen 3,4 s.
Der Holdout: eine Prüfung an anderen Mahlzeiten
Fehler haben wir nur im ersten Satz untersucht, und nur dort haben wir den Prompt abgestimmt. Der Holdout diente als Prüfung, und diese Seite nennt keine seiner einzelnen Mahlzeiten. GPT-6 Luna Pro, GPT-6.1 Sol und Claude Sonnet 5.5 liefen nicht darauf.
Tabelle 6. Sieben Konfigurationen am Holdout mit 200 Mahlzeiten
| Modell | Innerhalb 10 g, 95-%-Intervall | Mittlerer absoluter Fehler, g | Verzerrung, g | Fehler über 30 g | Fehlgeschlagene Scans | Kosten pro Scan, $ | Median-Zeit, s | Differenz zu Gemini 3.6 Flash, low, Punkte |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.6 Flash, medium | 73,0 % 67,2 bis 78,7 | 9,1 | −3,7 | 6,0 % | 0 | 0,0061 | 6,6 | +2,5 −1,0 bis +5,9 |
| Gemini 3.6 Flash, low * | 70,5 % 64,5 bis 76,4 | 9,1 | −2,9 | 6,0 % | 0 | 0,0033 | 3,7 | Basis |
| Gemini 3.7 Flash, low | 70,5 % 64,3 bis 76,4 | 9,1 | −3,6 | 6,5 % | 0 | 0,0034 | 3,8 | 0,0 −4,6 bis +4,6 |
| Gemini 3.7 Flash, medium | 68,5 % 62,1 bis 74,5 | 9,5 | −4,0 | 7,0 % | 0 | 0,0061 | 5,8 | −2,0 −6,7 bis +2,8 |
| Gemini 3.5 Flash-Lite, low | 68,5 % 62,2 bis 74,8 | 9,9 | −2,2 | 9,5 % | 0 | 0,0017 | 2,3 | −2,0 −7,5 bis +3,5 |
| Gemini 3.8 Flash, low | 67,0 % 60,3 bis 73,6 | 9,7 | −3,4 | 7,5 % | 0 | 0,0031 | 5,1 | −3,5 −8,0 bis +1,0 |
| GPT-6 Luna, low | 61,5 % 54,3 bis 68,6 | 12,0 | −0,1 | 12,5 % | 0 | 0,0004 | 8,2 | −9,0 −15,6 bis −2,6 |
- Der Vorsprung von Gemini 3.7 Flash wiederholte sich nicht: +5,5 Punkte im ersten Satz, 0,0 (−4,6 bis +4,6) im Holdout.
- GPT-6 Luna blieb unter Gemini 3.6 Flash: −9,0 Punkte (−15,6 bis −2,6).
- Gemini 3.5 Flash-Lite blieb beim Anteil gleichauf, −2,0 Punkte (−7,5 bis +3,5), mit mehr Fehlern über 30 g: 19 gegen 12.
- Reasoning medium bei Gemini 3.6 Flash gewann 2,5 Punkte, mit einem Intervall von −1,0 bis +5,9.
Die Datendatei nennt die Mahlzeiten des Holdouts, sie sind also nicht mehr unbekannt. Ein späterer Test braucht neue Mahlzeiten.
Wo alle Modelle scheitern
Die Größe der Mahlzeit bewegt den Anteil stärker als die Wahl des Modells. Unter 15 g Kohlenhydraten erreichen die acht Modelle 75 bis 93 %. Ab 60 g erreichen sie 18 bis 45 %. Über alle Mahlzeiten beträgt der Abstand zwischen den Modellen 20 Punkte.
Tabelle 7. Anteil innerhalb von 10 g nach Referenzwert der Kohlenhydrate, erster Satz
| Modell | Unter 15 g 81 Mahlzeiten | 15 bis 30 g 51 Mahlzeiten | 30 bis 60 g 46 Mahlzeiten | 60 g oder mehr 22 Mahlzeiten | Mittlerer Fehler ab 60 g, g | Zu niedrig ab 60 g |
|---|---|---|---|---|---|---|
| Gemini 3.7 Flash | 90 % | 67 % | 70 % | 32 % | −23,6 | 20 von 22 |
| Gemini 3.8 Flash | 93 % | 73 % | 54 % | 27 % | −23,5 | 20 von 22 |
| Gemini 3.5 Flash-Lite | 86 % | 65 % | 59 % | 36 % | −21,1 | 17 von 22 |
| Gemini 3.6 Flash * | 85 % | 71 % | 57 % | 18 % | −27,4 | 21 von 22 |
| GPT-6 Luna | 86 % | 59 % | 43 % | 45 % | −6,4 | 11 von 22 |
| GPT-6 Luna Pro | 84 % | 53 % | 48 % | 41 % | −6,8 | 16 von 22 |
| GPT-6.1 Sol | 80 % | 47 % | 48 % | 23 % | +2,2 | 10 von 22 |
| Claude Sonnet 5.5 | 75 % | 45 % | 37 % | 23 % | −21,2 | 11 von 15 |
Große Teller kommen zu niedrig heraus
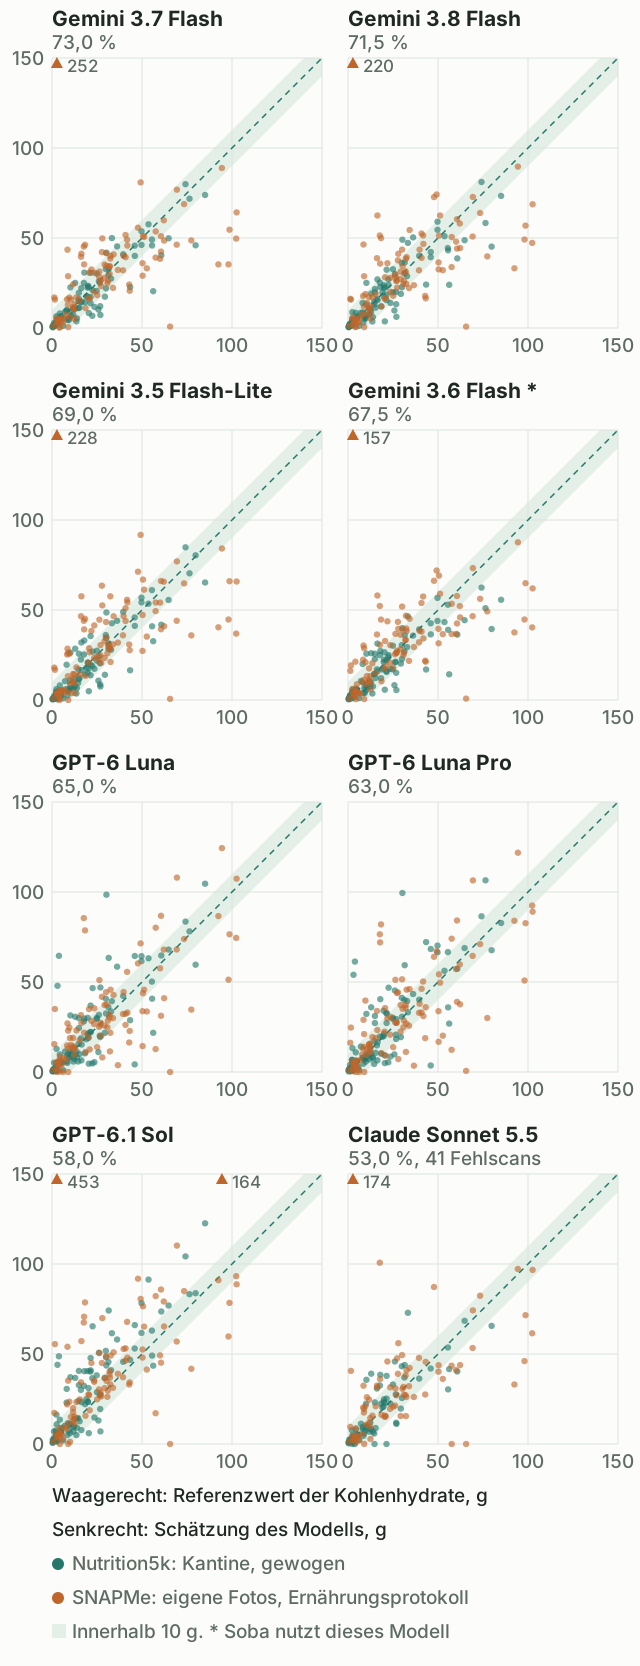
Ab 60 g schätzen Gemini 3.6, 3.7 und 3.8 Flash im Schnitt 23,5 bis 27,4 g zu niedrig. Zu niedrig liegen sie bei 20 oder 21 von 22 Mahlzeiten. Gemini 3.5 Flash-Lite und Claude Sonnet 5.5 schätzen etwa 21 g zu niedrig. Die Mittelwerte von OpenAI liegen näher an null, −6,8 bis +2,2 g, weil große Fehler in beide Richtungen gehen: GPT-6.1 Sol reicht von −65,6 bis +69,9 g. Ihre Anteile in diesem Bereich bleiben bei 23 bis 45 %.
Der Holdout bestätigt das. Bei seinen 20 Mahlzeiten ab 60 g schätzen fünf Modelle im Schnitt 19,3 bis 24,7 g zu niedrig. Zu niedrig liegen sie bei 14 bis 18 der 20 Mahlzeiten. Der höhere Anteil von GPT-6 Luna in diesem Bereich wiederholte sich nicht: 10 von 22 Mahlzeiten im ersten Satz, 5 von 20 im Holdout.
Tabelle 8. Geschätztes Gewicht geteilt durch Referenzgewicht, Median, erster Satz
| Modell | Unter 100 g 53 Mahlzeiten | 100 bis 200 g 44 Mahlzeiten | 200 bis 400 g 73 Mahlzeiten | 400 bis 600 g 25 Mahlzeiten | 600 g oder mehr 5 Mahlzeiten |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | 1,12 | 1,00 | 0,90 | 0,66 | 0,41 |
| Gemini 3.8 Flash | 1,17 | 1,00 | 0,89 | 0,67 | 0,47 |
| Gemini 3.5 Flash-Lite | 1,07 | 0,98 | 0,90 | 0,69 | 0,40 |
| Gemini 3.6 Flash * | 1,22 | 0,99 | 0,85 | 0,63 | 0,47 |
| GPT-6 Luna | 1,25 | 1,01 | 0,97 | 0,71 | 0,45 |
| GPT-6 Luna Pro | 1,27 | 1,02 | 1,00 | 0,74 | 0,40 |
| GPT-6.1 Sol | 1,73 | 1,23 | 1,18 | 0,92 | 0,53 |
| Claude Sonnet 5.5 | 1,22 | 1,04 | 0,93 | 0,70 | 0,39 |
Tabelle 8 zeigt auf das Portionsgewicht. Ein Wert von 1,00 bedeutet ein richtiges Gewicht. Alle acht Modelle ziehen Gewichte zu einer typischen Portion hin. Teller mit 400 bis 600 g kommen auf 0,63 bis 0,92, Teller ab 600 g auf 0,39 bis 0,53. Der Holdout ergibt 0,73 bis 0,80 und 0,43 bis 0,49, bei fünf Modellen.
- Ein gewogener Frühstücksteller mit 558 g kam auf 320 bis 530 g. Seine 79,8 g Kohlenhydrate kamen auf 39 bis 84 g.
- Ein Curry mit Reis, 662 g im Protokoll, kam auf 270 bis 445 g. Seine 98,0 g Kohlenhydrate kamen auf 35 bis 60 g.
- Drei ganze Kartoffeln, 510 g im Protokoll, kamen auf 180 bis 420 g. Ihre 102,4 g Kohlenhydrate kamen auf 37 bis 93 g.
Bei großen Tellern liegt eine Schätzung am häufigsten daneben. Eine Schätzung ersetzt das Wiegen nicht. Eine Küchenwaage und das Etikett liefern sicherere Zahlen.
Kleine Stücke kommen zu schwer heraus, mit wenig Folgen für die Kohlenhydrate
Unter 100 g reicht der Median im ersten Satz von 1,07 bis 1,73 und im Holdout von 0,92 bis 1,23. Allein auf gewogenen Tellern reicht er von 0,95 bis 1,73 und von 0,78 bis 1,06. Dieser Effekt ist schwächer als bei großen Tellern und hängt vom Satz ab. Er kostet auch wenig Kohlenhydrate. Gewogene Kirschtomaten mit 64 g kamen auf 80 bis 160 g, ihre 2,5 g Kohlenhydrate auf 4 bis 6 g.
Getränke
Ein Foto zeigt oft nicht, was in einem Glas ist. Ein Glas Kaffee hat im Protokoll 2,7 g Kohlenhydrate. Sechs Modelle lasen es als Karamellsauce oder Honig und antworteten 157 bis 453 g. Die zwei Luna-Modelle lasen es als Brühe oder braune Flüssigkeit und antworteten 2 g. Ohne diese Mahlzeit fällt der mittlere absolute Fehler der Gemini-Modelle auf 8,3 bis 9,4 g, während GPT-6 Luna bei 10,7 g bleibt.
Ein gesüßter Tee in einem Glas mit Teebeutel hat 65,6 g Kohlenhydrate im Protokoll. Alle acht Modelle antworteten 0 bis 1 g, weil man Zucker auf einem Foto nicht sieht.
Fehler in den Referenzwerten
Alle acht Modelle lagen bei 71 Mahlzeiten innerhalb von 10 g. Bei 19 Mahlzeiten schaffte das keines, und 15 davon sind SNAPMe-Fotos. Wir haben große Fehltreffer des ersten Satzes mit den Fotos verglichen und Fehler in den Referenzwerten gefunden. Wir haben keinen davon korrigiert, also senken sie den Anteil jedes Modells.
- Ein Protokolleintrag mit 25 g Keks, auf dem Foto fünf Kekse. Die Modelle schätzten 35 bis 100 g.
- Ein Protokolleintrag mit 29 g Blätterteig, auf dem Foto offenbar ein verpackter Mondkuchen. Die Modelle schätzten 50 bis 90 g.
- Ein Teller von Nutrition5k mit dem Eintrag 54 g Brownies, auf dem Foto eine Schüssel mit Reis, Karotten und Tomaten. Die Modelle schätzten 205 bis 310 g.
Was dieser Test nicht zeigt
- Er testet API-Modelle mit einem Prompt. Ein anderer Prompt könnte die Reihenfolge ändern, und dieser wurde an Gemini abgestimmt.
- Er beschreibt den Oktober 2026. Anbieter aktualisieren ihre Modelle, und diese Zahlen können schnell veralten.
- Er testet keine App für Endnutzer: Die Apps von ChatGPT und Gemini blieben außen vor, ebenso Soba in der täglichen Nutzung. Eine App bringt eigenen Prompt, eigene Bildverarbeitung und eigene Prüfungen mit.
- Er testet einen Weg pro Modell und kann ein Modell deshalb nicht von seinem Weg trennen.
- Er hat keine eigene menschliche Vergleichsgruppe. Niemand hat diese Mahlzeiten geschätzt, also sagt dieser Test nicht, ob ein Modell besser ist als ein Mensch.
- Alle Mahlzeiten stammen aus den USA. Die Teller von Nutrition5k stammen von einem einzigen Kameraaufbau, senkrecht von oben.
- Die Antwortsprache war Russisch. Andere Sprachen können abweichen.
- Er misst nur Kohlenhydrate. Eiweiß, Fett und Kalorien behandelt diese Seite nicht.
Veröffentlichte Zahlen für Menschen stammen von anderen Mahlzeiten und anderen Regeln, deshalb lassen sie sich mit diesen Tabellen nicht vergleichen. Brazeau et al. (2013) untersuchten 50 Erwachsene mit Typ-1-Diabetes und 448 Mahlzeiten. Ihre Schätzungen wichen im Schnitt um 15,4 g oder 20,9 % von der Zählung einer Diätassistenz ab. Bei Meade und Rushton (2016) erreichten 61 Patienten 44 % in einem Test mit Lebensmittelmodellen und 59 % ohne die Lebensmittel, die sie als nie gegessen markierten. Eine richtige Antwort wich höchstens 3 g von einer Spanne oder 5 g von einem Einzelwert ab.
Vergleich mit veröffentlichten Arbeiten
Andere Gruppen haben KI-Modelle an Essen verglichen, und dieser Test schließt an diese Arbeiten an. Nur die ersten zwei Zeilen von Tabelle 9 nutzen denselben Datensatz auf ähnliche Weise. Die übrigen Zeilen nutzen andere Mahlzeiten, Referenzwerte und Maße, deshalb lassen sich ihre Zahlen nicht zeilenübergreifend vergleichen.
Tabelle 9. Veröffentlichte Arbeiten und dieser Test
| Arbeit | Was getestet wurde | Ergebnis |
|---|---|---|
| Rodríguez-Jiménez et al., Nutrients 2025 | ChatGPT-5 in der Weboberfläche, 74 SNAPMe-Mahlzeiten, nur Foto. Die Autoren korrigierten einige Referenzwerte. | Mittlerer absoluter Fehler 12,99 g, Median 8,75 g. Mit einer Notiz zur Mahlzeit: 11,29 g und 8,05 g. |
| Dieser Test, SNAPMe-Hälfte | Acht API-Modelle, 100 SNAPMe-Mahlzeiten, nur Foto. Referenzwerte unverändert. | Gemini 3.6 Flash: mittlerer absoluter Fehler 13,7 g, Median 7,8 g. Gemini 3.7 Flash: 13,6 g und 6,4 g. |
| Nakagawa und Yamamoto, Nutrients 2026 | Sechs Modelle von drei Anbietern, 1.272 SNAPMe- und 887 NutriImage-Mahlzeiten, Prompt-Varianten. | Bei SNAPMe sitzt die Unterschätzung in den größeren Mahlzeiten. Die Anweisung, größer zu schätzen, hob bei Modellen von Anthropic und Gemini 83 bis 100 % der Bilder an, bei OpenAI-Modellen 34 bis 39 %. |
| Jin et al., DiningBench, ACL 2026 | 29 Modelle, 1.650 Gerichte mit je etwa 5 Fotos. Der gesamte Benchmark enthält vor allem chinesische Gerichte. Die Referenzwerte stammen aus Händlerdaten oder von Gemini-3-Pro-Preview, von Hand geprüft. | Mittlerer absoluter prozentualer Fehler bei Kohlenhydraten: Gemini-3-Pro-Preview 27,40 %, GPT-4.1 35,81 %, GPT-5 36,63 %, Claude-Sonnet-4.5 51,52 %. |
| Street, Diabettech 2026 | Preprint ohne Peer Review. Vier Modelle über Batch-APIs der Anbieter, 13 Fotos, 495 bis 561 Wiederholungen pro Foto, 26.904 Anfragen. | Mediane Streuung auf einem Foto (Variationskoeffizient): Claude Sonnet 4.6 2,4 %, GPT-5.4 8,4 %, Gemini 3.1 Pro 10,3 %, Gemini 2.5 Pro 11,0 %. Claude Sonnet 4.6 hatte auch den kleinsten mittleren absoluten Fehler, insgesamt 11,6 g. |
| Zagaroli et al., Diabetes Obes Metab 2026 | ChatGPT, Gemini, Claude und DeepSeek an 124 Mahlzeiten, die als Text beschrieben waren, ohne Fotos. Die Referenzwerte kamen von Fachleuten aus der Klinik. | Median der Kohlenhydrate: Fachleute 30,32 g, ChatGPT 30,75 g, Gemini 30,40 g, DeepSeek 29,75 g, Claude 29,25 g. |
| Tecce et al., Diabetes Care 2025 | ChatGPT-4o und Gemini Advanced gegen die Software MetaDieta. Den vollständigen Brief konnten wir nicht lesen, die Zahlen stammen aus einer Zusammenfassung von Type 1 Better. | Fehler von 35 bis 45 % bei wenigen Angaben. Bei mittleren Angaben 18 % für ChatGPT und 29 % für Gemini. Bei vollständigen Angaben etwa 13 %. |
Die Reihenfolge der Modelle ändert sich von Arbeit zu Arbeit. Claude Sonnet 4.5 hat den größten Fehler der vier aus DiningBench genannten Modelle. Claude Sonnet 4.6 zeigt im Preprint von Street die geringste Streuung und den kleinsten Fehler. Die Reihenfolge hängt von der Modellversion, dem Weg, dem Prompt und den Referenzwerten ab.
Interessenkonflikt
Ich, Maksim Danilchenko, habe diesen Test durchgeführt und diese Seite geschrieben. Ich entwickle Soba, eine App mit kostenpflichtigem Abo, die Kohlenhydrate aus Fotos schätzt, und habe Typ-1-Diabetes. Soba nutzt Gemini 3.6 Flash mit Reasoning low, eine der getesteten Konfigurationen. Der Prompt stammt von Soba. Ein Ergebnis zugunsten von Gemini passt zu meinem Geschäft, lies die Tabellen also mit diesem Wissen.
Sobas Einstellung liegt an 400 Mahlzeiten auf Platz fünf von sieben. Soba bleibt dabei, weil Gemini 3.7 Flash seinen Vorsprung im Holdout nicht hielt und Reasoning medium die Kosten verdoppelt. Sobas eigener API-Schlüssel hat die Läufe bezahlt. Daten und Skript sind öffentlich, du kannst also jede Tabelle prüfen.
So rechnest du nach
Leg das Skript und die Scan-Datei in einen Ordner und starte das Skript. Es braucht nur Python, dauert etwa 5 Sekunden und ruft kein Modell auf. Es gibt jede Zahl der Tabellen 1 bis 8 aus und die Ergebnisse, die im Text stehen. Wir haben es mit Python 3.11 und 3.13 getestet.
python3 reproduce.py- Ergebnisse pro Mahlzeit (CSV, 400 Zeilen, auf Englisch): ID des Gerichts, Datensatz, Referenzwert, dann Schätzung und Fehler je Modell.
- Alle Scans (CSV, 4.200 Zeilen, auf Englisch): eine Zeile pro Scan mit Status, Anfragen, geschätztem Gewicht, Zeit und Kosten.
- reproduce.py: nur Python-Standardbibliothek, mit dem oben beschriebenen Startwert und den Clustern.
Eine zweite Fassung der Berechnung mit NumPy ergibt dieselben Anteile, Fehler und Anzahlen. Ihre Intervallgrenzen weichen in den Tabellen 1, 2, 5 und 6 um bis zu 0,3 Punkte ab. In Tabelle 3 weichen sie um bis zu 1,0 ab, weil dort eine Mahlzeit einem Punkt entspricht.
Die Dateien enthalten weder die Fotos noch den Prompt. Die Fotos bekommst du über die ID des Gerichts aus den beiden Datensätzen. Jede Auswertung kannst du nachprüfen, ein neuer Lauf der Modelle braucht deinen eigenen Prompt.
Die Datendateien stehen unter CC BY-SA 4.0, der Lizenz von SNAPMe. Wir haben 400 Mahlzeiten aus den beiden Datensätzen ausgewählt, die Referenzwerte auf drei Dezimalstellen gerundet und die Antworten der Modelle ergänzt.
So zitierst du diesen Test
Danilchenko M. Eight AI models compared on carb estimates from meal photos. Soba, November 2026. https://soba-app.com/accuracy/models/
@misc{danilchenko2026models,
  author = {Danilchenko, Maksim},
  title = {Eight {AI} models compared on carb estimates from meal photos},
  year = {2026},
  month = nov,
  howpublished = {Soba},
  url = {https://soba-app.com/accuracy/models/},
  note = {Runs of 7 October 2026}
}
Ein Satz zum Zitieren: „In einem Test mit 200 Essensfotos lagen acht KI-Modelle bei 53 bis 73 % der Mahlzeiten innerhalb von 10 g der Referenz-Kohlenhydrate, wobei fehlgeschlagene Scans als Fehltreffer zählen (Soba, November 2026).“
Wenn du die Reihenfolge der Modelle zitierst, nenne bitte das Intervall. Nenne bitte auch, dass der Autor Soba entwickelt, eine App, die eines dieser Modelle nutzt.
Quellen
- Thames Q, Karpur A, Norris W, et al. Nutrition5k: Towards Automatic Nutritional Understanding of Generic Food. CVPR 2021, pp. 8903-8911. arXiv:2103.03375. Datensatz: github.com/google-research-datasets/Nutrition5k, CC BY 4.0.
- Chin EL, Larke JA, Bouzid YY, Nguyen T, Vainberg Y, Smilowitz JT, Lemay DG. SNAPMe: A Benchmark Dataset of Food Photos with Food Records for Evaluation of Computer Vision Algorithms in the Context of Dietary Assessment. Ag Data Commons, 2022. doi:10.15482/USDA.ADC/1528346, CC BY-SA 4.0.
- Larke JA, Chin EL, Bouzid YY, et al. Surveying Nutrient Assessment with Photographs of Meals (SNAPMe): A Benchmark Dataset of Food Photos for Dietary Assessment. Nutrients. 2023;15(23):4972. PMC10708545.
- Rodríguez-Jiménez et al. Image-Based Dietary Energy and Macronutrients Estimation with ChatGPT-5: Cross-Source Evaluation Across Escalating Context Scenarios. Nutrients. 2025;17(22):3613. PMC12655113.
- Nakagawa S, Yamamoto A. A Japanese-Dietitian Prompt Systematically Shifts Portion Estimates in LLM-Based Nutrient Estimation from Food Images: A Multi-Dataset, Multi-Model Study. Nutrients. 2026;18(17):2892. PMC13567310.
- Jin S, Zhang J, Zhang X, et al. DiningBench: A Hierarchical Multi-view Benchmark for Perception and Reasoning in the Dietary Domain. ACL 2026. arXiv:2604.10425.
- Street T. Reproducibility and accuracy of large language model vision APIs for carbohydrate estimation from food photographs (Kurztitel). Diabettech, April 2026. PDF.
- Zagaroli L, Caione N, Zara S, et al. Accuracy of ChatGPT, Gemini, Claude and DeepSeek in Carbohydrate Counting. Diabetes Obes Metab. 2026;28(7):5627-5636. PMID 41969183.
- Tecce N, Vetrani C, Pelosi AL, et al. AI-Powered Carbohydrate Counting for Type 1 Diabetes: Accuracy and Real-World Performance. Diabetes Care. 2025;48(8):e97-e98. PMID 40397829.
- Brazeau AS, Mircescu H, Desjardins K, et al. Carbohydrate counting accuracy and blood glucose variability in adults with type 1 diabetes. Diabetes Res Clin Pract. 2013;99(1):19-23. PMID 23146371.
- Meade LT, Rushton WE. Accuracy of Carbohydrate Counting in Adults. Clin Diabetes. 2016;34(3):142-147. PMC5019010.