 Soba
Сравнение моделей · октябрь 2026
Восемь моделей ИИ, 200 фото еды: от 53 до 73% оценок углеводов в пределах 10 г
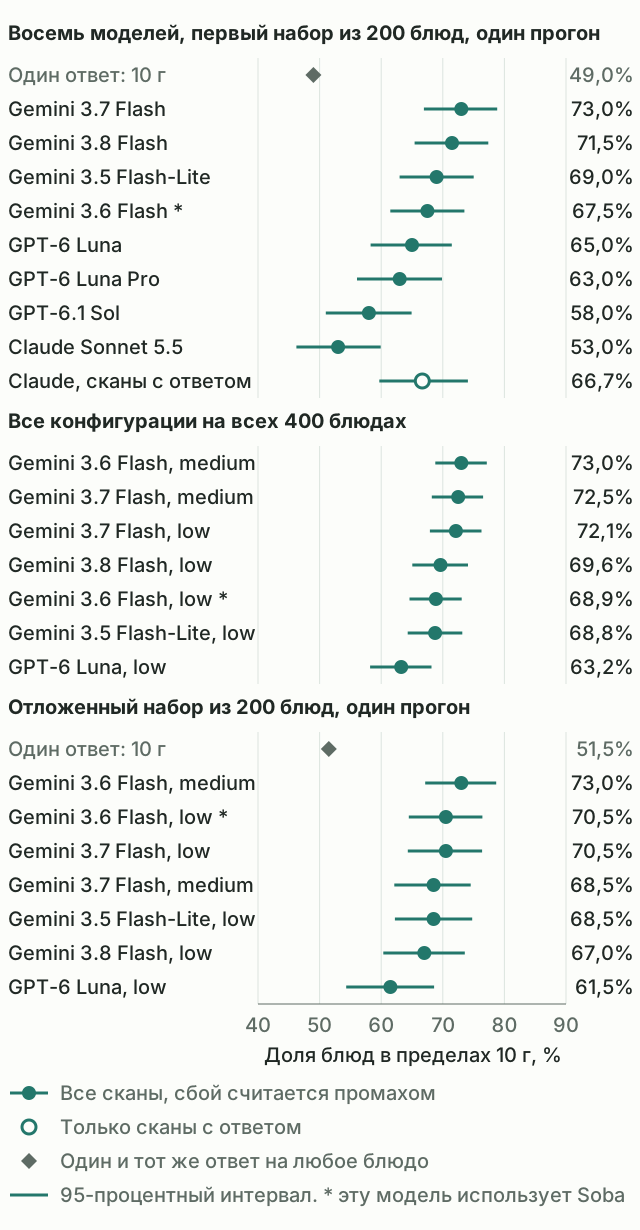
Четыре модели Gemini Flash набрали от 67,5 до 73,0%, три модели OpenAI от 58,0 до 65,0%. Claude Sonnet 5.5 набрала 53,0%, если считать 41 сбой скана промахами, и 66,7% на сканах с ответом. Интервалы четырёх моделей Gemini пересекаются, поэтому этот тест не называет одну лучшую модель.
73,0%максимум у четырёх моделей Gemini Flash, они набрали от 67,5 до 73,0%
65,0%максимум у трёх моделей OpenAI, они набрали от 58,0 до 65,0%
53,0%Claude Sonnet 5.5 через OpenRouter и Azure, на сканах с ответом 66,7%
Где оказалась каждая модель
Все восемь моделей получили одни и те же 200 фото и один и тот же промпт, по одному прогону. Сбой скана считается промахом в доле в пределах 10 г. Остальные столбцы с ошибками считаются только по сканам с ответом.
Таблица 1. Восемь моделей на первом наборе из 200 блюд
| Модель | В пределах 10 г, 95-процентный интервал | Средняя абсолютная ошибка, г | Смещение, г | Ошибки больше 30 г | Сбои сканов | Цена скана, $ | Медианное время, с |
|---|---|---|---|---|---|---|---|
| Gemini 3.7 Flash | 73,0% от 66,9 до 78,8 | 9,5 | −1,0 | 5,5% | 0 | 0,0036 | 3,7 |
| Gemini 3.8 Flash | 71,5% от 65,4 до 77,4 | 9,9 | −0,8 | 7,0% | 0 | 0,0030 | 4,8 |
| Gemini 3.5 Flash-Lite | 69,0% от 63,0 до 75,0 | 10,2 | +0,4 | 6,0% | 0 | 0,0017 | 2,1 |
| Gemini 3.6 Flash * | 67,5% от 61,5 до 73,5 | 10,1 | −1,4 | 5,5% | 0 | 0,0028 | 3,3 |
| GPT-6 Luna | 65,0% от 58,3 до 71,5 | 10,7 | +1,2 | 8,0% | 0 | 0,0003 | 6,9 |
| GPT-6 Luna Pro | 63,0% от 56,1 до 69,9 | 11,1 | +1,9 | 8,0% | 0 | 0,0010 | 11,7 |
| GPT-6.1 Sol | 58,0% от 51,0 до 64,9 | 14,9 | +10,1 | 11,5% | 0 | 0,0071 | 13,1 |
| Claude Sonnet 5.5 | 53,0% от 46,2 до 59,9 | 10,9 | +1,1 | 6,3% | 41 | 0,0145 | 6,0 |
| Claude Sonnet 5.5, только сканы с ответом | 66,7% от 59,7 до 74,1 | 10,9 | +1,1 | 6,3% | 0 | 0,0138 | 5,2 |
* Эту модель использует Soba, с reasoning low. Звёздочка отмечает её во всех таблицах. Вторая строка доли: её 95-процентный интервал. Ошибки больше 30 г даны как доля сканов с ответом.
- Шкала начинается примерно с 50%. Один и тот же ответ 10 г на любое блюдо набрал бы 49,0%, потому что в 49,0% этих блюд не больше 20 г углеводов.
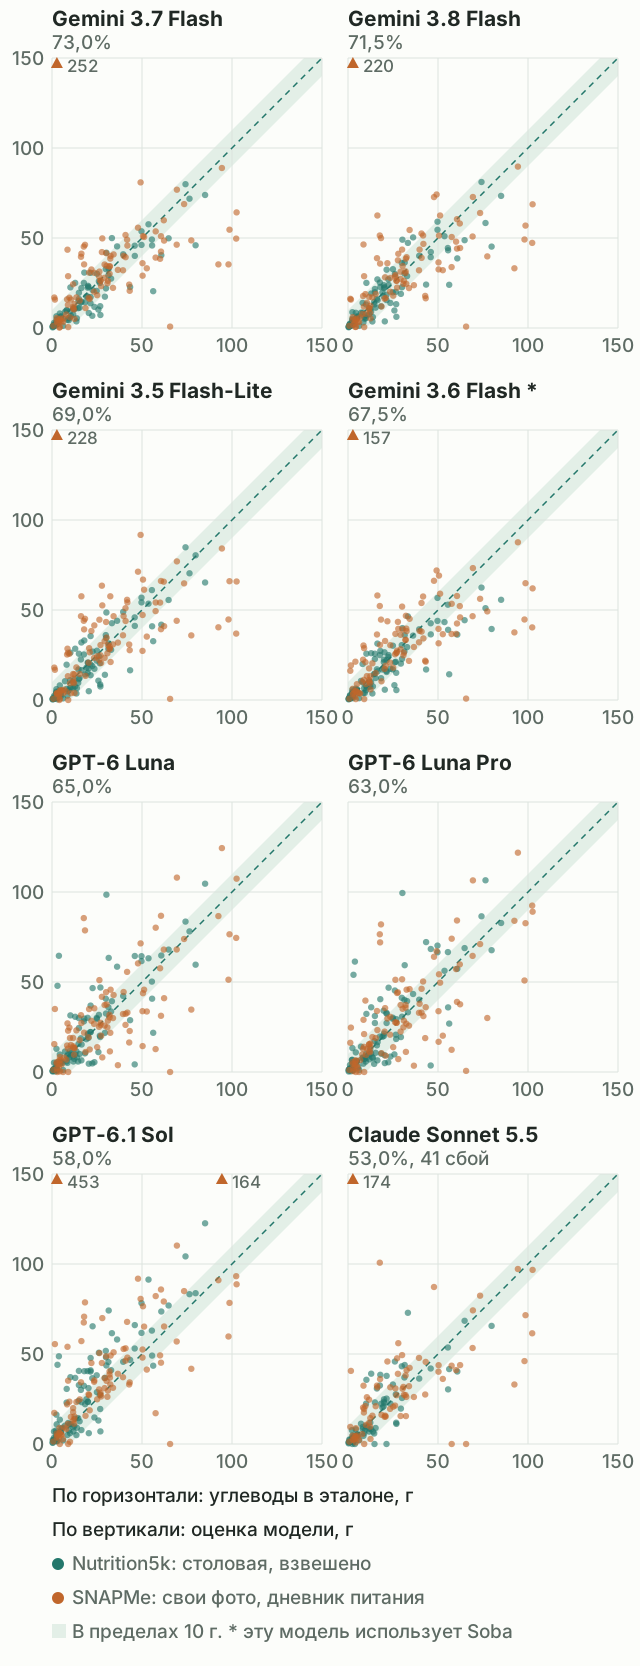
- GPT-6.1 Sol завышает сильнее всех, в среднем на 10,1 г. Остальные семь моделей держатся в пределах 2 г от нуля.
- GPT-6 Luna стоит меньше всех, $0,0003 за скан. Claude Sonnet 5.5 стоит больше всех, $0,0145.
- Gemini 3.5 Flash-Lite работает быстрее всех, медиана 2,1 с. GPT-6.1 Sol работает медленнее всех, 13,1 с.
Что мы измеряли
Скан отправляет модели одно фото и спрашивает, что на тарелке. Модель отвечает чистыми углеводами и клетчаткой по каждому продукту. Мы складываем их, потому что в датасетах указаны общие углеводы. Затем сравниваем сумму с эталонным значением блюда.
Главная мера: доля блюд, где разница не больше 10 г. Границу 10 г выбрали мы, а по файлу с данными можно проверить любую другую.
- Средняя абсолютная ошибка: средний размер ошибки в граммах.
- Смещение: средняя ошибка со знаком. Минус значит, что модель занижает.
- Ошибки больше 30 г: грубые промахи, доля от сканов с ответом.
- Сбой скана: скан без корректного ответа после одного повтора. В доле в пределах 10 г он считается промахом, а в остальных столбцах ошибки у него нет.
- Цена скана: сумма, которую OpenRouter списал за прогон, с учётом повторов.
- Медианное время: весь скан, с учётом повторов.
Данные
Фото и эталонные значения взяты из двух открытых научных датасетов. В каждом наборе из 200 блюд по 100 блюд из каждого датасета.
Nutrition5k: взвешенные тарелки
Тарелки Nutrition5k собраны в столовых Google. Каждый ингредиент взвешен, а каждое фото сделано неподвижной камерой строго сверху. Это самые надёжные эталонные значения в тесте. Лицензия CC BY 4.0.
SNAPMe: домашние фото и дневник питания
SNAPMe собрали Министерство сельского хозяйства США и Калифорнийский университет в Дейвисе. 95 человек в США фотографировали свои блюда перед едой и вели дневник питания в ASA24, инструменте для оценки рациона. Эталонное значение равно сумме строк дневника, связанных с фото, поэтому в нём есть ошибки дневника. Лицензия CC BY-SA 4.0.
Издатель называет бенчмарки оценки питательных веществ одним из назначений датасета и просит не обучать на этом небольшом наборе модели. Этот тест ничего не обучает. На этой странице и в файлах с данными нет фото SNAPMe.
Как скрипт отбирал блюда
Скрипт с фиксированным зерном брал по 25 блюд из каждой четверти диапазона углеводов в каждом датасете. Исходный набор: 505 тарелок из официальной тестовой части Nutrition5k и 1457 фото SNAPMe, снятых до еды. От одного участника SNAPMe скрипт брал не больше 2 фото. Тарелки из одного десятиминутного окна часто похожи, поэтому для первого набора он брал 1 тарелку на окно, а для отложенного до 3.
Отложенный набор скрипт выбрал тем же способом. С первым набором у него нет общих фото, блюд и десятиминутных окон, но участники SNAPMe могут встречаться в обоих. Медиана эталонного значения 20,3 г в первом наборе и 19,1 г в отложенном.
Методика и протокол промпта
Каждый скан отправил одно фото и один и тот же промпт через OpenRouter 7 октября 2026 года. Подсказок, данных о глубине и последующих правок не было. Мы уменьшили каждое фото до 1024 пикселей по длинной стороне, качество JPEG 70. Код теста задавал русский язык ответа.
- Провайдер: OpenRouter выбрал Google AI Studio для Gemini, OpenAI для моделей OpenAI и Azure для Claude. Запрос запрещал переход на другую модель и задавал
data_collectionравнымdeny. - Формат ответа: строгая JSON-схема. Проверка отклоняет пустое название продукта и вес вне диапазона от 0 до 5000 г, затем отправляет один повтор с причиной.
- Reasoning: low у всех восьми моделей. У разных поставщиков low значит разное. В среднем на первую попытку это от 0 до 39 токенов рассуждения у Gemini и Claude и от 68 до 590 у OpenAI.
- Температура: 0,2, кроме моделей OpenAI, которые эту настройку не принимают.
- Лимит ответа: 8192 токена на первом наборе, 4096 на отложенном и 16 384 с reasoning medium. Обычные ответы укладываются в 3000 токенов.
Промпт словами
Это промпт, который Soba использовала в октябре 2026 года. Его текст мы не публикуем и описываем здесь. Он просит модель сделать следующее:
- Назвать каждый съедобный продукт и разбить составное блюдо на части.
- Оценить вес сначала по масштабу: предметы известного размера, площадь на высоту слоя и плотность или число штук на вес штуки.
- Указать основание для каждого веса и дать минимум и максимум.
- Дать питательность на 100 г в показанном виде, чистые углеводы и клетчатку отдельно.
- Переписать значения с видимой этикетки.
Мы написали и настроили этот промпт на Gemini, поэтому он может давать преимущество Gemini.
Интервалы
95-процентные интервалы получены кластерным бутстрепом с 10 000 повторов и зерном 20261007. Кластером служит один участник SNAPMe или одно десятиминутное окно Nutrition5k. Скрипт повторно выбирает кластеры внутри каждого датасета, и оба датасета весят одинаково. Разницы между моделями используют одни и те же повторы на одних и тех же блюдах.
Поправку на множественные сравнения мы не делали. Восемь моделей дают 28 пар, так что одна или две пары могут исключить ноль случайно.
Результаты на 200 блюдах: какие разрывы держатся
Таблица 2 сравнивает модели блюдо за блюдом. Жирным выделена разница, 95-процентный интервал которой исключает ноль. Минус значит, что модель в строке набрала меньше, чем модель в столбце.
Таблица 2. Разницы на первом наборе, в пунктах
| Модель | Разница с Gemini 3.7 Flash, пункты | Разница с Gemini 3.8 Flash, пункты | Разница с Gemini 3.5 Flash-Lite, пункты | Разница с Gemini 3.6 Flash, пункты |
|---|---|---|---|---|
| Gemini 3.7 Flash | база | +1,5 от −2,5 до +5,5 | +4,0 от −1,4 до +9,4 | +5,5 от +0,9 до +10,3 |
| Gemini 3.8 Flash | −1,5 от −5,5 до +2,5 | база | +2,5 от −2,5 до +7,7 | +4,0 от −0,5 до +8,6 |
| Gemini 3.5 Flash-Lite | −4,0 от −9,4 до +1,4 | −2,5 от −7,7 до +2,5 | база | +1,5 от −3,0 до +6,0 |
| Gemini 3.6 Flash * | −5,5 от −10,3 до −0,9 | −4,0 от −8,6 до +0,5 | −1,5 от −6,0 до +3,0 | база |
| GPT-6 Luna | −8,0 от −14,5 до −1,5 | −6,5 от −13,2 до +0,4 | −4,0 от −10,5 до +2,7 | −2,5 от −9,5 до +4,7 |
| GPT-6 Luna Pro | −10,0 от −17,1 до −3,0 | −8,5 от −15,5 до −1,5 | −6,0 от −13,0 до +1,0 | −4,5 от −12,0 до +2,9 |
| GPT-6.1 Sol | −15,0 от −22,1 до −7,7 | −13,5 от −20,7 до −6,0 | −11,0 от −17,5 до −4,6 | −9,5 от −16,1 до −2,7 |
| Claude Sonnet 5.5 | −20,0 от −26,6 до −13,1 | −18,5 от −25,0 до −11,8 | −16,0 от −22,4 до −9,5 | −14,5 от −20,9 до −8,0 |
- Четыре модели Gemini Flash близки. Одна из их шести пар исключает ноль: Gemini 3.7 Flash против Gemini 3.6 Flash, +5,5 пункта. Отложенный набор этого не повторил.
- GPT-6.1 Sol и Claude Sonnet 5.5, если считать сбои промахами, ниже всех четырёх моделей Gemini Flash.
- GPT-6 Luna ниже только Gemini 3.7 Flash. GPT-6 Luna Pro ниже Gemini 3.7 и 3.8 Flash. Остальные их разницы включают ноль.
Повторные прогоны показывают шум. Gemini 3.6, 3.7 и 3.8 Flash прошли эти фото дважды. Их доли изменились с 67,5 до 67,0%, с 73,0 до 74,5% и с 71,5 до 73,0%. Исход совпал на доле блюд от 94,5 до 95,5%. Медианный разрыв между двумя ответами на одно фото около 1 г, самый большой 59,5 г.
Таблица 3. Тот же прогон по датасетам
| Модель | Nutrition5k, взвешено: в пределах 10 г | Nutrition5k: средняя абсолютная ошибка, г | SNAPMe, дневник: в пределах 10 г | SNAPMe: средняя абсолютная ошибка, г |
|---|---|---|---|---|
| Gemini 3.7 Flash | 82,0% от 74,0 до 89,0 | 5,4 | 64,0% от 54,5 до 73,2 | 13,6 |
| Gemini 3.8 Flash | 80,0% от 72,0 до 87,0 | 5,9 | 63,0% от 53,5 до 72,1 | 13,9 |
| Gemini 3.5 Flash-Lite | 81,0% от 73,0 до 88,0 | 5,7 | 57,0% от 47,1 до 66,7 | 14,7 |
| Gemini 3.6 Flash * | 80,0% от 72,0 до 87,0 | 6,4 | 55,0% от 45,5 до 64,4 | 13,7 |
| GPT-6 Luna | 71,0% от 62,0 до 80,0 | 8,6 | 59,0% от 49,0 до 68,6 | 12,7 |
| GPT-6 Luna Pro | 66,0% от 57,0 до 75,0 | 9,3 | 60,0% от 49,5 до 69,6 | 12,9 |
| GPT-6.1 Sol | 60,0% от 50,0 до 70,0 | 11,1 | 56,0% от 46,0 до 66,0 | 18,6 |
| Claude Sonnet 5.5 | 57,0% от 47,0 до 67,0 | 6,8 | 49,0% от 39,4 до 58,6 | 14,7 |
Разрыв между Gemini и OpenAI находится на взвешенных тарелках. Там четыре модели Gemini Flash набирают от 80 до 82%, а модели OpenAI от 60 до 71%. GPT-6 Luna Pro и GPT-6.1 Sol ниже Gemini 3.6 Flash на 14 и 20 пунктов, их интервалы исключают ноль.
На домашних фото модели OpenAI набирают от 56 до 60%, это внутри диапазона Gemini от 55 до 64%. Там только Gemini 3.7 и 3.8 Flash отличаются от Gemini 3.6 Flash с интервалами без нуля, на +9 и +8 пунктов. Домашние фото сложнее для всех моделей, а дневники добавляют свои ошибки.
Другие прогоны
Другие прогоны на этих фото меняли протокол, поэтому в таблицы не вошли. В них были другие версии промпта, отключённая температура, reasoning high, подсказки и данные о глубине. Страница точности рассказывает о подсказках, глубине и более позднем коде Soba, который набрал 68,5% на 400 блюдах там, где таблица 5 показывает 68,9%. Девятая модель, Gemini 3.1 Pro Preview, прошла на более позднем коде без температуры и набрала 66,0% (от 59,3 до 72,5). В наших записях есть ещё модель Qwen, которую мы убрали после короткой пробы. Сырых данных от неё мы не сохранили, поэтому цифр по ней здесь нет.
Claude Sonnet 5.5 через OpenRouter и Azure
Сбои сканов есть только у Claude Sonnet 5.5, поэтому у неё два взгляда. Если считать сбои промахами, она набирает 53,0%. На 159 сканах с ответом она набирает 66,7%. Первый взгляд показывает, что человек получит по этому маршруту. Второй показывает модель, когда она отвечает.
OpenRouter отправил все 286 запросов в Azure, и каждый вернул HTTP 200 с обычным завершением. В 86 из 200 первых попыток в ответе был один продукт с пустым названием и 0 г, а название блюда было заполнено. Наша проверка отклонила такие ответы и отправила один повтор.
- 41 повтор снова вернулся пустым. Это и есть 41 сбой скана: 24 на Nutrition5k и 17 на SNAPMe.
- 40 повторов дали настоящий ответ.
- 5 повторов дали заглушку: один продукт с названием «x», 1 г и без питательных веществ. Наша проверка их приняла, поэтому они считаются оценками 0 г, и 2 из них попали в пределы 10 г.
Таблица 4. Все модели на блюдах, где Claude ответила
| Модель | 159 блюд: в пределах 10 г | 159 блюд: средняя абсолютная ошибка, г | Разница с Claude, пункты | 154 блюда: в пределах 10 г | 154 блюда: средняя абсолютная ошибка, г |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | 73,0% от 66,7 до 79,9 | 10,1 | +6,3 от 0,0 до +12,8 | 72,1% | 10,3 |
| Gemini 3.8 Flash | 73,0% от 66,7 до 79,6 | 10,3 | +6,3 от 0,0 до +12,8 | 72,1% | 10,5 |
| Gemini 3.5 Flash-Lite | 71,7% от 65,4 до 78,7 | 10,2 | +5,0 от −1,0 до +11,7 | 70,8% | 10,5 |
| Gemini 3.6 Flash * | 69,2% от 62,9 до 76,4 | 10,1 | +2,5 от −3,6 до +9,1 | 68,2% | 10,4 |
| GPT-6 Luna | 67,3% от 60,4 до 74,8 | 10,0 | +0,6 от −6,9 до +8,2 | 68,2% | 9,7 |
| GPT-6 Luna Pro | 64,8% от 57,3 до 72,2 | 10,5 | −1,9 от −10,0 до +5,9 | 66,2% | 10,2 |
| GPT-6.1 Sol | 62,9% от 55,1 до 70,8 | 14,5 | −3,8 от −11,7 до +3,7 | 64,3% | 14,3 |
| Claude Sonnet 5.5 | 66,7% от 59,7 до 74,1 | 10,9 | база | 67,5% | 10,6 |
На 159 блюдах Gemini 3.7 и 3.8 Flash набирают 73,0%. Это на 6,3 пункта выше Claude с интервалом от 0,0 до +12,8, а все остальные разницы включают ноль. Без 5 заглушек, на 154 блюдах, Claude набирает 67,5%, и все разницы включают ноль. Значит, на блюдах, где Claude ответила, она в пределах интервалов на уровне остальных моделей.
У обоих взглядов есть ограничения. Цифра 53,0% может описывать маршрут и мало говорить о модели. Другой маршрут мы не пробовали и не знаем, откуда взялись пустые продукты. Цифра 66,7% оставляет в стороне 41 блюдо, а оставшиеся 159 немного проще. Остальные семь моделей прибавляют на них от 0,0 до 4,9 пункта. Повторы к тому же стоят дороже: $0,0113 за скан с одним запросом и $0,0189 с двумя.
В отдельном препринте Claude Sonnet 4.6 через пакетный API Anthropic вернула разобранные продукты на всех запросах (Street, таблица 9). Там другая версия модели и другой маршрут, поэтому этот результат он не объясняет.
Семь конфигураций на всех 400 блюдах
Таблица 5 объединяет первый и отложенный наборы. В ней каждая конфигурация, которая прошла все 400 блюд: пять настроек Gemini Flash, Gemini 3.5 Flash-Lite и GPT-6 Luna. Gemini 3.6, 3.7 и 3.8 Flash с reasoning low прошли первый набор дважды, поэтому два прогона усредняются по блюду. Цена и время считаются по всем сканам конфигурации.
Таблица 5. Каждая конфигурация на всех 400 блюдах
| Модель | В пределах 10 г, 95-процентный интервал | Средняя абсолютная ошибка, г | Смещение, г | Ошибки больше 30 г | Сбои сканов | Цена скана, $ | Медианное время, с | Разница с Gemini 3.6 Flash, low, пункты |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.6 Flash, medium | 73,0% от 68,8 до 77,1 | 9,4 | −2,7 | 5,5% | 0 | 0,0059 | 6,6 | +4,1 от +1,6 до +6,7 |
| Gemini 3.7 Flash, medium | 72,5% от 68,2 до 76,5 | 9,3 | −3,0 | 6,8% | 0 | 0,0060 | 5,8 | +3,6 от +0,2 до +7,1 |
| Gemini 3.7 Flash, low | 72,1% от 67,9 до 76,3 | 9,3 | −2,3 | 6,0% | 0 | 0,0034 | 3,7 | +3,2 от +0,3 до +6,4 |
| Gemini 3.8 Flash, low | 69,6% от 65,1 до 74,1 | 9,8 | −2,2 | 7,2% | 0 | 0,0030 | 5,0 | +0,8 от −2,3 до +3,9 |
| Gemini 3.6 Flash, low * | 68,9% от 64,6 до 73,1 | 9,5 | −2,0 | 5,8% | 0 | 0,0031 | 3,4 | база |
| Gemini 3.5 Flash-Lite, low | 68,8% от 64,3 до 73,2 | 10,0 | −0,9 | 7,8% | 0 | 0,0017 | 2,2 | −0,1 от −3,5 до +3,4 |
| GPT-6 Luna, low | 63,2% от 58,2 до 68,2 | 11,4 | +0,5 | 10,2% | 0 | 0,0003 | 7,6 | −5,6 от −10,3 до −1,0 |
Три конфигурации выше настройки Soba, Gemini 3.6 Flash с reasoning low, с интервалами без нуля: +4,1, +3,6 и +3,2 пункта. GPT-6 Luna ниже неё на 5,6 пункта, интервал от −10,3 до −1,0.
Две проверки ослабляют эти прибавки. Gemini 3.7 Flash лидировала на первом наборе среди восьми моделей, поэтому первый набор её завышает. На одном отложенном наборе её преимущество над Gemini 3.6 Flash равно 0,0 пункта.
Reasoning medium у Gemini 3.6 Flash прибавляет в основном на границе 10 г. В пределах 5 г он набирает 49,0% против 50,2%, а ошибок больше 30 г остаётся 22 против 23. Он к тому же удваивает цену, $0,0059 против $0,0031, и время, 6,6 с против 3,4 с.
Отложенный набор: проверка на других блюдах
Ошибки мы разбирали и промпт настраивали только на первом наборе. Отложенный набор служил проверкой, и эта страница не разбирает его отдельные блюда. GPT-6 Luna Pro, GPT-6.1 Sol и Claude Sonnet 5.5 его не проходили.
Таблица 6. Семь конфигураций на отложенном наборе из 200 блюд
| Модель | В пределах 10 г, 95-процентный интервал | Средняя абсолютная ошибка, г | Смещение, г | Ошибки больше 30 г | Сбои сканов | Цена скана, $ | Медианное время, с | Разница с Gemini 3.6 Flash, low, пункты |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.6 Flash, medium | 73,0% от 67,2 до 78,7 | 9,1 | −3,7 | 6,0% | 0 | 0,0061 | 6,6 | +2,5 от −1,0 до +5,9 |
| Gemini 3.6 Flash, low * | 70,5% от 64,5 до 76,4 | 9,1 | −2,9 | 6,0% | 0 | 0,0033 | 3,7 | база |
| Gemini 3.7 Flash, low | 70,5% от 64,3 до 76,4 | 9,1 | −3,6 | 6,5% | 0 | 0,0034 | 3,8 | 0,0 от −4,6 до +4,6 |
| Gemini 3.7 Flash, medium | 68,5% от 62,1 до 74,5 | 9,5 | −4,0 | 7,0% | 0 | 0,0061 | 5,8 | −2,0 от −6,7 до +2,8 |
| Gemini 3.5 Flash-Lite, low | 68,5% от 62,2 до 74,8 | 9,9 | −2,2 | 9,5% | 0 | 0,0017 | 2,3 | −2,0 от −7,5 до +3,5 |
| Gemini 3.8 Flash, low | 67,0% от 60,3 до 73,6 | 9,7 | −3,4 | 7,5% | 0 | 0,0031 | 5,1 | −3,5 от −8,0 до +1,0 |
| GPT-6 Luna, low | 61,5% от 54,3 до 68,6 | 12,0 | −0,1 | 12,5% | 0 | 0,0004 | 8,2 | −9,0 от −15,6 до −2,6 |
- Преимущество Gemini 3.7 Flash не повторилось: +5,5 пункта на первом наборе, 0,0 (от −4,6 до +4,6) на отложенном.
- GPT-6 Luna осталась ниже Gemini 3.6 Flash: −9,0 пункта (от −15,6 до −2,6).
- Gemini 3.5 Flash-Lite осталась на уровне по доле, −2,0 пункта (от −7,5 до +3,5), и ошибок больше 30 г у неё больше: 19 против 12.
- Reasoning medium у Gemini 3.6 Flash прибавил 2,5 пункта с интервалом от −1,0 до +5,9.
Файл с данными перечисляет блюда отложенного набора, так что они больше не закрыты. Следующему тесту нужны новые блюда.
Где ошибаются все модели
Размер блюда двигает долю сильнее, чем выбор модели. При углеводах меньше 15 г восемь моделей набирают от 75 до 93%. При 60 г и больше они набирают от 18 до 45%. По всем блюдам разрыв между моделями 20 пунктов.
Таблица 7. Доля в пределах 10 г по эталонным углеводам, первый набор
| Модель | Меньше 15 г 81 блюдо | От 15 до 30 г 51 блюдо | От 30 до 60 г 46 блюд | 60 г и больше 22 блюда | Средняя ошибка от 60 г, г | Занижено от 60 г |
|---|---|---|---|---|---|---|
| Gemini 3.7 Flash | 90% | 67% | 70% | 32% | −23,6 | 20 из 22 |
| Gemini 3.8 Flash | 93% | 73% | 54% | 27% | −23,5 | 20 из 22 |
| Gemini 3.5 Flash-Lite | 86% | 65% | 59% | 36% | −21,1 | 17 из 22 |
| Gemini 3.6 Flash * | 85% | 71% | 57% | 18% | −27,4 | 21 из 22 |
| GPT-6 Luna | 86% | 59% | 43% | 45% | −6,4 | 11 из 22 |
| GPT-6 Luna Pro | 84% | 53% | 48% | 41% | −6,8 | 16 из 22 |
| GPT-6.1 Sol | 80% | 47% | 48% | 23% | +2,2 | 10 из 22 |
| Claude Sonnet 5.5 | 75% | 45% | 37% | 23% | −21,2 | 11 из 15 |
Большие тарелки выходят заниженными
При 60 г и больше Gemini 3.6, 3.7 и 3.8 Flash занижают в среднем на величину от 23,5 до 27,4 г. Заниженными выходят 20 или 21 блюдо из 22. Gemini 3.5 Flash-Lite и Claude Sonnet 5.5 занижают примерно на 21 г. Средние OpenAI ближе к нулю, от −6,8 до +2,2 г, потому что большие ошибки идут в обе стороны. У GPT-6.1 Sol они идут от −65,6 до +69,9 г. Их доли в этой группе остаются от 23 до 45%.
Отложенный набор это подтверждает. На его 20 блюдах с 60 г и больше пять моделей занижают в среднем на величину от 19,3 до 24,7 г. Заниженными выходят от 14 до 18 блюд из 20. Более высокая доля GPT-6 Luna в этой группе не повторилась: 10 блюд из 22 на первом наборе, 5 из 20 на отложенном.
Таблица 8. Оценка веса, делённая на эталонный вес, медиана, первый набор
| Модель | Меньше 100 г 53 блюда | От 100 до 200 г 44 блюда | От 200 до 400 г 73 блюда | От 400 до 600 г 25 блюд | 600 г и больше 5 блюд |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | 1,12 | 1,00 | 0,90 | 0,66 | 0,41 |
| Gemini 3.8 Flash | 1,17 | 1,00 | 0,89 | 0,67 | 0,47 |
| Gemini 3.5 Flash-Lite | 1,07 | 0,98 | 0,90 | 0,69 | 0,40 |
| Gemini 3.6 Flash * | 1,22 | 0,99 | 0,85 | 0,63 | 0,47 |
| GPT-6 Luna | 1,25 | 1,01 | 0,97 | 0,71 | 0,45 |
| GPT-6 Luna Pro | 1,27 | 1,02 | 1,00 | 0,74 | 0,40 |
| GPT-6.1 Sol | 1,73 | 1,23 | 1,18 | 0,92 | 0,53 |
| Claude Sonnet 5.5 | 1,22 | 1,04 | 0,93 | 0,70 | 0,39 |
Таблица 8 указывает на вес порции. Значение 1,00 означает верный вес. Все восемь моделей тянут вес к типичной порции. Тарелки от 400 до 600 г выходят на уровне от 0,63 до 0,92, а тарелки от 600 г на уровне от 0,39 до 0,53. На отложенном наборе это от 0,73 до 0,80 и от 0,43 до 0,49 у пяти моделей.
- Взвешенная тарелка с завтраком на 558 г вышла на уровне от 320 до 530 г. Её 79,8 г углеводов вышли на уровне от 39 до 84 г.
- Карри с рисом, 662 г по дневнику, вышло на уровне от 270 до 445 г. Его 98,0 г углеводов вышли на уровне от 35 до 60 г.
- Три целые картофелины, 510 г по дневнику, вышли на уровне от 180 до 420 г. Их 102,4 г углеводов вышли на уровне от 37 до 93 г.
На больших тарелках оценка промахивается чаще всего. Оценка не заменяет взвешивание. Кухонные весы и этикетка дают более надёжные цифры.
Мелкие продукты выходят тяжелее, но углеводы меняются мало
При весе меньше 100 г медиана идёт от 1,07 до 1,73 на первом наборе и от 0,92 до 1,23 на отложенном. На одних взвешенных тарелках она идёт от 0,95 до 1,73 и от 0,78 до 1,06. Этот эффект слабее, чем на больших тарелках, и зависит от набора. Углеводов он меняет мало. Взвешенные помидоры черри на 64 г вышли на уровне от 80 до 160 г, а их 2,5 г углеводов от 4 до 6 г.
Напитки
Фото часто не показывает, что в стакане. В банке кофе по дневнику 2,7 г углеводов. Шесть моделей приняли её за карамельный соус или мёд и ответили от 157 до 453 г. Две модели Luna приняли её за бульон или коричневую жидкость и ответили 2 г. Без этого блюда средняя абсолютная ошибка моделей Gemini падает до значений от 8,3 до 9,4 г, а у GPT-6 Luna остаётся 10,7 г.
В сладком чае в банке с чайным пакетиком по дневнику 65,6 г углеводов. Все восемь моделей ответили от 0 до 1 г, потому что сахара на фото не видно.
Ошибки в эталонных значениях
Все восемь моделей попали в пределы 10 г на 71 блюде. Ни одна не попала на 19 блюдах, и 15 из них взяты из SNAPMe. Мы сверили крупные промахи первого набора с фото и нашли ошибки в эталонных значениях. Мы не исправляли ни одну, поэтому они снижают долю всех моделей.
- В дневнике 25 г печенья, на фото пять печений. Модели оценили от 35 до 100 г.
- В дневнике 29 г слойки, на фото похоже на лунный пряник в упаковке. Модели оценили от 50 до 90 г.
- В разметке Nutrition5k 54 г брауни, на фото миска с рисом, морковью и помидорами. Модели оценили от 205 до 310 г.
Чего этот тест не показывает
- Он проверяет модели через API с одним промптом. Другой промпт может изменить порядок, а этот настроен на Gemini.
- Он описывает октябрь 2026 года. Поставщики обновляют модели, и эти цифры могут быстро устареть.
- Он не проверяет приложения для пользователей: ни ChatGPT, ни Gemini, ни Soba в обычной работе. У приложения свой промпт, своя обработка фото и свои проверки.
- Он проверяет один маршрут на модель, поэтому не может отделить модель от маршрута.
- В нём нет своей базы сравнения с людьми. Эти блюда не оценивал ни один человек, поэтому тест не говорит, точнее ли модель, чем человек.
- Все блюда из США. Тарелки Nutrition5k сняты на одном стенде, строго сверху.
- Язык ответа был русским. На других языках результат может отличаться.
- Он измеряет только углеводы. Белок, жир и калории на этой странице не разбираются.
Опубликованные цифры для людей получены на других блюдах и по другим правилам, поэтому с этими таблицами они не сравниваются. Brazeau и соавторы (2013) изучили 50 взрослых с диабетом 1 типа и 448 блюд. Их оценки отличались от подсчёта диетолога в среднем на 15,4 г, или 20,9%. У Meade и Rushton (2016) 61 пациент набрал 44% в тесте с муляжами еды и 59% без продуктов, которые отметил как те, что не ест никогда. Верный ответ отличался не больше чем на 3 г от диапазона или на 5 г от одного значения.
Сравнение с опубликованными работами
Другие группы тоже сравнивали модели ИИ на еде, так что этот тест дополняет уже существующие работы. Только первые две строки таблицы 9 используют один датасет похожим образом. В остальных строках другие блюда, эталоны и метрики, поэтому их цифры между строками не сравниваются.
Таблица 9. Опубликованные работы и этот тест
| Работа | Что проверяли | Результат |
|---|---|---|
| Rodríguez-Jiménez и соавторы, Nutrients 2025 | ChatGPT-5 в веб-интерфейсе, 74 блюда SNAPMe, только фото. Авторы исправили часть эталонных значений. | Средняя абсолютная ошибка 12,99 г, медиана 8,75 г. С заметкой о блюде: 11,29 г и 8,05 г. |
| Этот тест, половина SNAPMe | Восемь моделей через API, 100 блюд SNAPMe, только фото. Эталонные значения без правок. | Gemini 3.6 Flash: средняя абсолютная ошибка 13,7 г, медиана 7,8 г. Gemini 3.7 Flash: 13,6 г и 6,4 г. |
| Nakagawa и Yamamoto, Nutrients 2026 | Шесть моделей трёх поставщиков, 1272 блюда SNAPMe и 887 блюд NutriImage, варианты промпта. | На SNAPMe занижение сосредоточено в более крупных блюдах. Указание оценивать больше подняло от 83 до 100% изображений у моделей Anthropic и Gemini и от 34 до 39% у моделей OpenAI. |
| Jin и соавторы, DiningBench, ACL 2026 | 29 моделей, 1650 блюд, примерно по 5 фото на блюдо. В бенчмарке в целом в основном китайская еда. Эталонные значения взяты у продавцов или от Gemini-3-Pro-Preview и проверены вручную. | Средняя абсолютная ошибка в процентах по углеводам: Gemini-3-Pro-Preview 27,40%, GPT-4.1 35,81%, GPT-5 36,63%, Claude-Sonnet-4.5 51,52%. |
| Street, Diabettech 2026 | Препринт без рецензирования. Четыре модели через пакетные API поставщиков, 13 фото, от 495 до 561 повтора на фото, 26 904 запроса. | Медианный разброс на одном фото (коэффициент вариации): Claude Sonnet 4.6 2,4%, GPT-5.4 8,4%, Gemini 3.1 Pro 10,3%, Gemini 2.5 Pro 11,0%. У Claude Sonnet 4.6 также самая низкая средняя абсолютная ошибка, 11,6 г в целом. |
| Zagaroli и соавторы, Diabetes Obes Metab 2026 | ChatGPT, Gemini, Claude и DeepSeek на 124 блюдах, описанных текстом, без фото. Эталонные значения дали клиницисты. | Медиана углеводов: клиницисты 30,32 г, ChatGPT 30,75 г, Gemini 30,40 г, DeepSeek 29,75 г, Claude 29,25 г. |
| Tecce и соавторы, Diabetes Care 2025 | ChatGPT-4o и Gemini Advanced в сравнении с программой MetaDieta. Полный текст письма мы прочитать не смогли, цифры взяты из пересказа Type 1 Better. | Ошибки от 35 до 45% при минимуме данных. При среднем объёме данных 18% у ChatGPT и 29% у Gemini. При полных данных около 13%. |
Порядок моделей меняется от работы к работе. У Claude Sonnet 4.5 самая большая ошибка из четырёх моделей, приведённых из DiningBench. У Claude Sonnet 4.6 самый маленький разброс и самая низкая ошибка в препринте Street. Порядок зависит от версии модели, маршрута, промпта и эталонных значений.
Конфликт интересов
Этот тест провёл и эту страницу написал я, Максим Данильченко. Я делаю Soba, приложение с платной подпиской, которое оценивает углеводы по фото, и у меня диабет 1 типа. Soba использует Gemini 3.6 Flash с reasoning low, одну из проверенных конфигураций. Промпт взят из Soba. Результат в пользу Gemini выгоден моему делу, учитывайте это при чтении таблиц.
Настройка Soba занимает пятое место из семи на 400 блюдах. Soba остаётся на ней, потому что Gemini 3.7 Flash не удержала преимущество на отложенном наборе, а reasoning medium удваивает цену. Прогоны оплачены собственным ключом API Soba. Данные и скрипт открыты, поэтому каждую таблицу можно проверить.
Как воспроизвести
Положите скрипт и файл со сканами в одну папку и запустите скрипт. Ему нужен только Python, он работает около 5 секунд и не обращается к моделям. Он печатает все числа таблиц с 1 по 8 и результаты из текста. Мы проверили его на Python 3.11 и 3.13.
python3 reproduce.py- Результаты по блюдам (CSV, 400 строк, на английском): идентификатор блюда, датасет, эталонные углеводы, затем оценка и ошибка по каждой модели.
- Все сканы (CSV, 4200 строк, на английском): одна строка на скан со статусом, запросами, оценкой веса, временем и ценой.
- reproduce.py: только стандартная библиотека Python, зерно и кластеры описаны выше.
Вторая версия расчётов на NumPy даёт те же доли, ошибки и количества. Её границы интервалов отличаются на величину до 0,3 пункта в таблицах 1, 2, 5 и 6. В таблице 3 они отличаются на величину до 1,0, потому что там одно блюдо равно одному пункту.
В файлах нет фото и промпта. Фото можно получить из двух датасетов по идентификатору блюда. Любой расчёт можно проверить, а для нового прогона моделей нужен свой промпт.
Файлы с данными распространяются по CC BY-SA 4.0, лицензии SNAPMe. Мы выбрали 400 блюд из двух датасетов, округлили эталонные значения до трёх знаков и добавили ответы моделей.
Как цитировать
Danilchenko M. Eight AI models compared on carb estimates from meal photos. Soba, November 2026. https://soba-app.com/accuracy/models/
@misc{danilchenko2026models,
  author = {Danilchenko, Maksim},
  title = {Eight {AI} models compared on carb estimates from meal photos},
  year = {2026},
  month = nov,
  howpublished = {Soba},
  url = {https://soba-app.com/accuracy/models/},
  note = {Runs of 7 October 2026}
}
Фраза для цитаты: «В тесте на 200 фото еды восемь моделей ИИ попали в пределы 10 г от эталонных углеводов на доле блюд от 53 до 73%, сбои сканов считаются промахами (Soba, ноябрь 2026)».
Если цитируете порядок моделей, добавьте интервал. Укажите также, что автор делает Soba, приложение на одной из этих моделей.
Источники
- Thames Q, Karpur A, Norris W, et al. Nutrition5k: Towards Automatic Nutritional Understanding of Generic Food. CVPR 2021, pp. 8903-8911. arXiv:2103.03375. Датасет: github.com/google-research-datasets/Nutrition5k, CC BY 4.0.
- Chin EL, Larke JA, Bouzid YY, Nguyen T, Vainberg Y, Smilowitz JT, Lemay DG. SNAPMe: A Benchmark Dataset of Food Photos with Food Records for Evaluation of Computer Vision Algorithms in the Context of Dietary Assessment. Ag Data Commons, 2022. doi:10.15482/USDA.ADC/1528346, CC BY-SA 4.0.
- Larke JA, Chin EL, Bouzid YY, et al. Surveying Nutrient Assessment with Photographs of Meals (SNAPMe): A Benchmark Dataset of Food Photos for Dietary Assessment. Nutrients. 2023;15(23):4972. PMC10708545.
- Rodríguez-Jiménez et al. Image-Based Dietary Energy and Macronutrients Estimation with ChatGPT-5: Cross-Source Evaluation Across Escalating Context Scenarios. Nutrients. 2025;17(22):3613. PMC12655113.
- Nakagawa S, Yamamoto A. A Japanese-Dietitian Prompt Systematically Shifts Portion Estimates in LLM-Based Nutrient Estimation from Food Images: A Multi-Dataset, Multi-Model Study. Nutrients. 2026;18(17):2892. PMC13567310.
- Jin S, Zhang J, Zhang X, et al. DiningBench: A Hierarchical Multi-view Benchmark for Perception and Reasoning in the Dietary Domain. ACL 2026. arXiv:2604.10425.
- Street T. Reproducibility and accuracy of large language model vision APIs for carbohydrate estimation from food photographs (краткое название). Diabettech, апрель 2026. PDF.
- Zagaroli L, Caione N, Zara S, et al. Accuracy of ChatGPT, Gemini, Claude and DeepSeek in Carbohydrate Counting. Diabetes Obes Metab. 2026;28(7):5627-5636. PMID 41969183.
- Tecce N, Vetrani C, Pelosi AL, et al. AI-Powered Carbohydrate Counting for Type 1 Diabetes: Accuracy and Real-World Performance. Diabetes Care. 2025;48(8):e97-e98. PMID 40397829.
- Brazeau AS, Mircescu H, Desjardins K, et al. Carbohydrate counting accuracy and blood glucose variability in adults with type 1 diabetes. Diabetes Res Clin Pract. 2013;99(1):19-23. PMID 23146371.
- Meade LT, Rushton WE. Accuracy of Carbohydrate Counting in Adults. Clin Diabetes. 2016;34(3):142-147. PMC5019010.